BLOG
Uma suíte verde é evidência suficiente para liberar software?
Um pipeline verde mostra que um conjunto de verificações passou. Para liberar, é preciso saber se elas eram relevantes para o risco da mudança, se o resultado é confiável e o que acontece se algo escapar.
Sumário
- 1. A questão
- 2. Quatro palavras que costumam virar uma só
- 3. O que o verde informa
- 4. O que o verde não informa
- 4.1 Se as asserções verificam o que importa
- 4.2 Se a cobertura acompanha o risco
- 4.3 Se o resultado é confiável
- 4.4 Reexecutar não é apagar
- 4.5 O que acontece fora do ambiente de teste
- 5. Exemplo hipotético: uma API de transferências com suíte verde
- 6. Rollback e feature flag não desfazem tudo
- 7. Modelo de decisão
- 8. Como eu abordaria esse problema hoje
- 9. Limitações
- 10. Conclusão: qualidade é reduzir risco com evidências
Resumo. Um pipeline verde informa que um conjunto específico de verificações passou, numa versão e num ambiente específicos. Isso é um resultado de teste, não uma decisão. Para liberar, é preciso perguntar se essas verificações eram relevantes para o risco da mudança, se o resultado é confiável, se a evidência é suficiente e o que acontece se algo escapar. Este artigo propõe um modelo conceitual de decisão com essas perguntas e termina numa tese: qualidade é reduzir risco com evidências.
1. A questão
Quando a suíte fica verde, o que de fato sabemos sobre a versão que vai para produção, e o que ainda falta saber antes de decidir liberar?
A pergunta parece simples porque o verde é binário. A decisão de release não é.
2. Quatro palavras que costumam virar uma só
Boa parte da confusão vem de tratar como sinônimos quatro coisas diferentes:
| Conceito | O que é | Exemplo |
|---|---|---|
| Resultado de teste | O que uma verificação retornou numa execução | "Os 1.240 testes passaram no commit abc123" |
| Evidência | Uma informação que, pela forma como foi obtida, diz algo sobre um risco específico. Pode existir ou não; e, quando existe, pode ser mais ou menos relevante, forte e confiável | "O teste de transferência concorrente passou 50 vezes seguidas com dados isolados" |
| Confiança | O quanto as evidências reunidas reduzem a incerteza sobre os riscos que importam | "Os riscos de saldo e autorização têm evidência; o de integração com o banco parceiro, não" |
| Decisão de release | A escolha de liberar, reduzir o escopo ou segurar, tomada por quem responde pelo resultado | "Libera para 5% dos clientes, com alerta de divergência de saldo" |
O mesmo resultado pode ser evidência forte para uma pergunta e fraca, ou irrelevante, para outra: a relevância e a força dependem da pergunta investigada e da confiabilidade da informação. Por isso, quatro perguntas diferentes qualificam uma evidência:
- Existência: há alguma verificação sobre este risco?
- Relevância: ela exercita o risco que importa, ou um vizinho dele?
- Força: o quanto ela distingue o comportamento certo do errado (asserção, oráculo, dados, quantidade de casos)?
- Confiabilidade: o resultado se repete nas mesmas condições, sem depender de ordem, ambiente ou sorte?
A confiança depende de quais riscos têm evidência e de como ela se sai nessas quatro perguntas. A decisão junta essa confiança ao contexto de negócio, que nenhum teste mede.
3. O que o verde informa
- Que as verificações efetivamente executadas nesta rodada passaram. Testes ignorados, desativados ou que não chegaram a rodar não entram nessa conta, e vale conferir quantos foram. É uma informação real, barata de repetir e que reduz a necessidade de conferência manual a cada entrega.
- Que as verificações executadas não detectaram regressão. A formulação importa: o verde indica que nenhuma regressão foi detectada por elas, não que não exista regressão.
- Um sinal sobre o fluxo de entrega, não sobre o produto inteiro. O DORA recomenda suítes rápidas e confiáveis, executadas no pipeline a cada mudança, e diz que, quando os testes passam, a equipe deveria ter confiança de que o software pode ser liberado. O mesmo texto mantém atividades manuais, como testes exploratórios e de usabilidade, ao longo da entrega, e põe entre os erros comuns tolerar testes instáveis e deixar a suíte crescer sem curadoria. Ou seja: a confiança que o verde deveria trazer é uma meta a construir, não uma propriedade automática.
O DORA mede a entrega por throughput (tempo de espera da mudança, frequência de deploy e tempo de recuperação de deploy com falha) e por instabilidade (taxa de falha de mudança e taxa de retrabalho de deploy). As medidas de instabilidade são observadas depois do deploy. O verde é uma entrada desse processo, não o resultado que se quer medir.
Em muitas equipes, o verde é condição de entrada razoável para liberar. Mas há contextos em que se libera com uma falha conhecida e aceita, ou em que um verde não basta. Tratar o verde como obrigatório ou como suficiente, em todos os casos, troca uma decisão por uma regra.
4. O que o verde não informa
4.1 Se as asserções verificam o que importa
Um teste que executa o código mas verifica pouco passa com facilidade. Uma asserção que só confere o status HTTP 200 de uma transferência não verifica se o saldo mudou, se mudou uma vez só ou se mudou na conta certa.
Por trás de toda asserção existe um oráculo de teste: o critério que diz qual é a resposta correta. Quando o oráculo é fraco (só o status), incompleto (só um campo) ou copiado da própria implementação (o teste espera o que o código já faz), a suíte passa e o defeito continua lá.
4.2 Se a cobertura acompanha o risco
Fowler descreve a cobertura como útil para encontrar partes do código sem teste, mas de pouco valor como número que diga quão bons os testes são; e alerta que, quando a cobertura vira meta, as pessoas passam a perseguir o número.
Cobertura de código mede quais elementos do código foram executados, segundo o critério adotado (linhas, ramos, condições). Cobertura de risco pergunta outra coisa: para cada coisa que pode dar errado nesta mudança, existe uma verificação capaz de falhar se ela der errado? Uma suíte pode ter cobertura alta e nenhuma verificação para concorrência, permissão ou consistência de dados.
4.3 Se o resultado é confiável
Dois erros possíveis de resultado, com nomes que mudam de equipe para equipe, e uma situação que não é erro de resultado. Neste texto:
- Falso positivo: o teste falha sem que exista defeito no produto (dado sujo, ambiente instável, ordem de execução).
- Falso negativo: o teste exercita o cenário e passa apesar de existir defeito nele (asserção fraca, oráculo errado).
- Lacuna de evidência: o cenário não foi exercitado. Não há resultado, nem verdadeiro nem falso; há ausência de evidência sobre aquele risco (seção 4.2).
O falso positivo é barulhento e consome horas. O falso negativo é silencioso e pode chegar à produção sem que ninguém perceba.
Em 2016, o Google relatou, sobre a própria infraestrutura de testes, que cerca de 1,5% das execuções davam resultado instável, que quase 16% dos testes tinham algum grau de instabilidade e que cerca de 84% das transições de teste passando para teste falhando, observadas no monitoramento depois da submissão, envolviam um teste instável. São números de uma empresa, de um momento e de uma escala específicos. Não servem como taxa da indústria. O que eles mostram é o mecanismo: com instabilidade suficiente, a passagem de um teste para falha deixa de indicar, por si só, se houve defeito.
Participei de um projeto em que os testes dependiam uns dos outros: para um teste começar, outro precisava ter rodado antes, porque usava os dados deixados por ele. Se o teste anterior deixasse de excluir algum dado, ou excluísse o que não devia, o seguinte não conseguia andar. Isso quebrava a esteira, gerava resultados falsos e tornava difícil agir com assertividade, além de consumir horas e horas.
Esse tipo de dependência pode produzir os dois erros. Um teste pode falhar porque o anterior deixou os dados num estado inesperado (falso positivo). E um teste pode passar porque encontrou dados preparados por outro teste, e não pelo próprio cenário; se isso esconder um defeito, por exemplo na criação desses dados, o resultado é um falso negativo. Em ambos os casos, o resultado passa a depender da ordem de execução, e não só do produto.
4.4 Reexecutar não é apagar
Reexecutar um teste que falhou pode ser legítimo. A diferença está no que acontece com a evidência original:
| Reexecução justificada | Reexecução que mascara |
|---|---|
| A falha original fica registrada | O resultado final substitui o original |
| Há uma hipótese para a falha (ambiente, dado) | Repete até ficar verde, sem hipótese |
| O teste instável vai para uma lista com dono e prazo | O teste continua no fluxo como se fosse confiável |
| A taxa de reexecução é acompanhada | Ninguém sabe quantas vezes o verde precisou de nova tentativa |
O DORA recomenda não tolerar testes instáveis, porque eles corroem a confiança na suíte. Uma reexecução que apaga a falha original destrói justamente a informação que permitiria corrigir a instabilidade.
4.5 O que acontece fora do ambiente de teste
O capítulo Canarying Releases, do Site Reliability Workbook do Google, define canary como uma implantação parcial e por tempo limitado de uma mudança, seguida de avaliação, e parte do fato de que ambientes de teste não são idênticos à produção: tráfego real revela problemas que testes de unidade ou de carga não mostram. O próprio capítulo aponta limites: canary e controle podem compartilhar dados e dependências, o que confunde a comparação. Ao discutir o espelhamento de tráfego (traffic teeing), técnica que o capítulo distingue do canary, ele observa que esse recurso não identifica bem o risco em sistemas com estado.
O canary limita a exposição: se algo der errado, menos clientes são afetados. Ele não substitui a investigação prévia de riscos que não são aceitáveis nem em pequena escala. Em operações financeiras, um débito em duplicidade para 1% dos clientes ainda é dinheiro de clientes reais, e precisa ser investigado antes do deploy.
Testes exploratórios ocupam um espaço parecido antes do deploy: alguém investigando o que a suíte não pergunta. Uma sessão exploratória útil parte de uma pergunta ("o que acontece se o cliente repetir a transferência enquanto a primeira ainda está em processamento?"), registra o que foi tentado, o que foi observado e com que dados, e termina em evidência anexada (registros, capturas, consultas) ou num teste automatizado novo. Sem esse registro, o que se descobriu perde rastreabilidade: fica difícil saber o que foi coberto, repetir a investigação e comunicar a evidência a quem decide. Tanto o exploratório quanto o canary produzem evidência que a suíte automatizada não produz.
5. Exemplo hipotético: uma API de transferências com suíte verde
Uma API financeira expõe POST /transferencias. A mudança da semana altera o cálculo de tarifa. A suíte tem 400 testes e está verde. Ela verifica: transferência válida, saldo insuficiente, valor negativo, conta inexistente e o novo cálculo de tarifa.
Riscos que essa suíte não avalia:
| Risco | O que pode acontecer | Por que a suíte não vê | Evidência que faltaria |
|---|---|---|---|
| Idempotência | O cliente não recebe resposta por timeout, repete o pedido e a transferência é feita duas vezes | Cada teste envia o pedido uma vez | Teste que repete o mesmo pedido com a mesma chave de idempotência e verifica que o efeito não se repete (um único débito, estado final correto) e que a resposta segue o contrato da API, seja ela a mesma resposta ou outra definida no contrato |
| Concorrência | Duas transferências simultâneas da mesma conta passam na checagem de saldo e deixam a conta negativa | Os testes rodam em sequência | Teste com pedidos paralelos e verificação do saldo final |
| Autorização | Um usuário autenticado transfere a partir da conta de outra pessoa trocando o identificador | Os testes usam um token com acesso a todas as contas | Teste com dois usuários, verificando recusa no acesso cruzado |
| Consistência de dados | O débito é gravado, o crédito falha e não há compensação | O ambiente de teste não simula falha parcial | Teste com falha injetada entre débito e crédito, verificando estado final consistente |
Por hipótese, esses riscos já existiam antes da mudança de tarifa, o que não exclui que ela os afete (uma tarifa calculada em outra etapa pode, por exemplo, mudar o que é gravado no débito). De todo modo, liberar a mudança coloca em produção a API inteira, com eles. A suíte verde informa que o cálculo de tarifa passou nas verificações existentes e que o que já era verificado continua passando. Não informa se é seguro mover dinheiro com esta versão.
6. Rollback e feature flag não desfazem tudo
Reverter o código não reverte o que o código já fez.
No exemplo da seção 5, se a versão debitou duas vezes, desligar a funcionalidade ou voltar a versão anterior pode conter novos erros, desde que o mecanismo realmente cubra o caminho afetado e não haja processamentos já em andamento. Mesmo assim, o dinheiro já saiu da conta do cliente. O mesmo vale para mensagens enviadas, dados apagados, migrações de esquema sem caminho de volta e integrações com terceiros que já processaram o pedido. Para esses efeitos, a recuperação é outra: compensação, conciliação, comunicação com clientes. Ela precisa ser planejada antes, não descoberta depois.
Por isso, a pergunta "conseguimos voltar?" precisa vir acompanhada de "o que não volta?".
7. Modelo de decisão
O modelo abaixo é uma proposta conceitual para organizar uma decisão baseada em evidências, a partir das fontes e da prática. Não é um método validado cientificamente nem pretende ser inédito; serve como roteiro de perguntas.
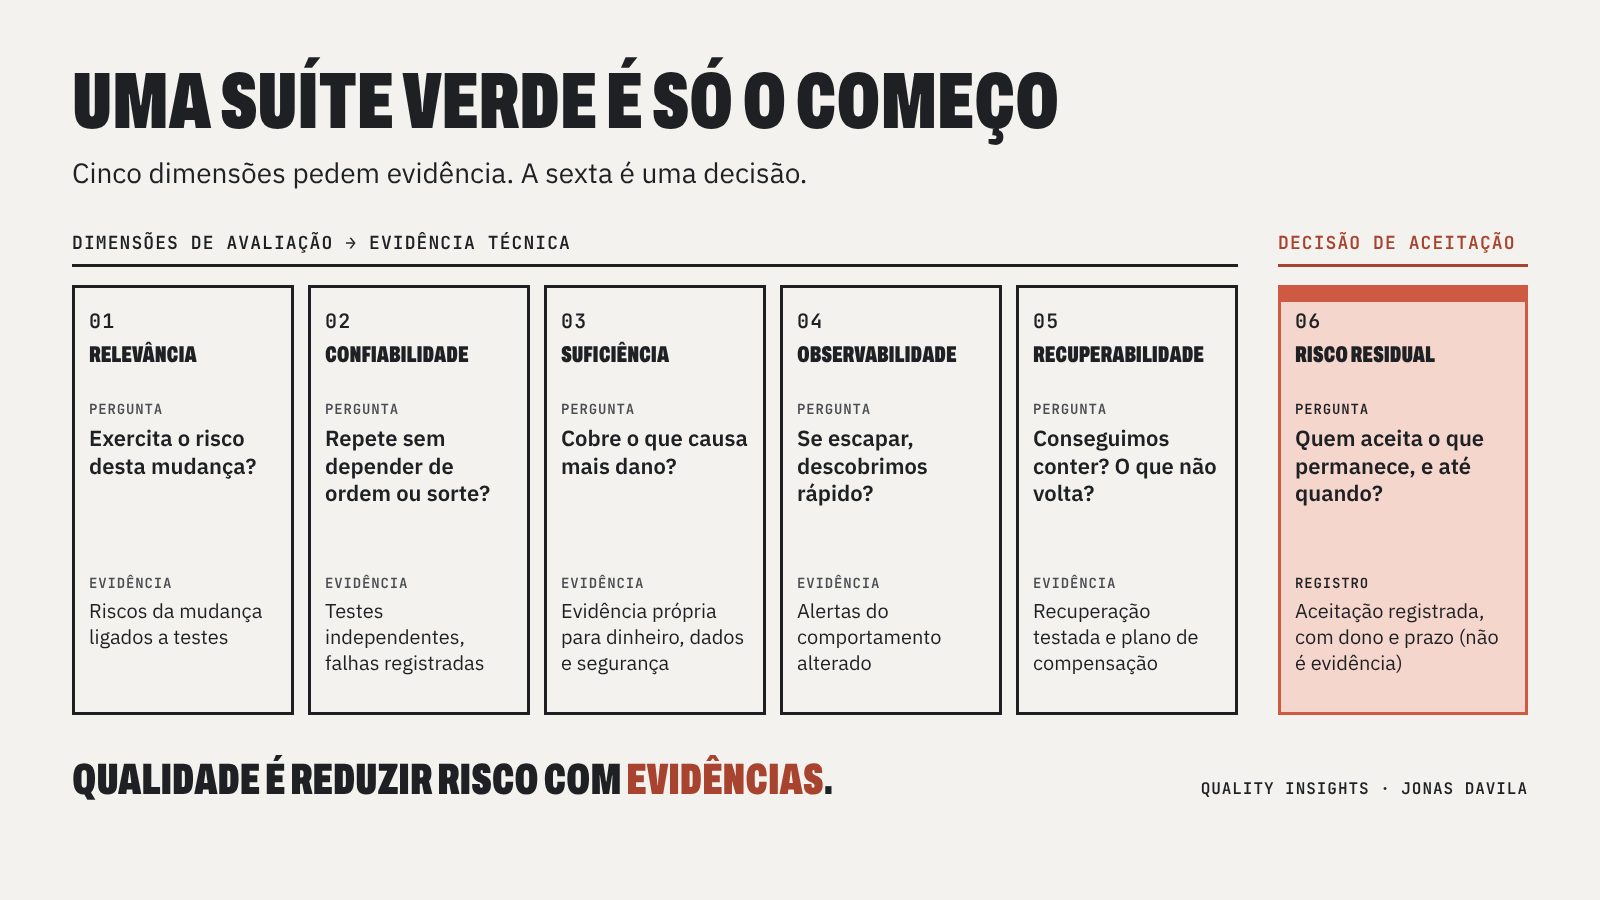
Descrição da figura. Uma suíte verde é só o começo. Cinco dimensões pedem evidência; a sexta é uma decisão.
- Relevância. Pergunta: exercita o risco desta mudança? Evidência: riscos da mudança ligados a testes.
- Confiabilidade. Pergunta: repete sem depender de ordem ou sorte? Evidência: testes independentes, falhas registradas.
- Suficiência. Pergunta: cobre o que causa mais dano? Evidência: evidência própria para dinheiro, dados e segurança.
- Observabilidade. Pergunta: se escapar, descobrimos rápido? Evidência: alertas do comportamento alterado.
- Recuperabilidade. Pergunta: conseguimos conter? O que não volta? Evidência: recuperação testada e plano de compensação.
- Risco residual, decisão de aceitação. Pergunta: quem aceita o que permanece, e até quando? Registro: aceitação registrada, com dono e prazo; não é evidência.
Qualidade é reduzir risco com evidências.
São seis perguntas antes de liberar. As cinco primeiras pedem evidência técnica. A sexta é de outra natureza: é a decisão de aceitar o risco que permanece. Ele inclui o que ficou sem evidência suficiente, mas não só isso: mesmo com verificações favoráveis e controles aplicados, costuma sobrar alguma incerteza, porque testes e controles reduzem o risco sem, em geral, eliminá-lo por completo. Aceitar um risco não produz evidência sobre ele; só registra que alguém escolheu conviver com ele.
| Critério | Pergunta | Evidência mínima | Sinal de alerta |
|---|---|---|---|
| Relevância | As verificações exercitam os riscos desta mudança? | Lista curta de riscos da mudança, cada um ligado a um teste ou a uma verificação manual; o que ficar sem verificação vai para o risco residual | Suíte verde sem nenhum teste novo para uma mudança de regra |
| Confiabilidade | O resultado pode ser repetido e não depende de ordem ou de dados deixados por outro teste? | Testes independentes, falhas originais registradas, taxa de reexecução conhecida | "Passou na terceira tentativa" sem registro |
| Suficiência | A evidência reunida cobre o que pode causar mais dano? | Riscos de maior impacto (dinheiro, dados, segurança) com evidência própria | Só caminho feliz testado numa operação financeira |
| Observabilidade | Se algo escapar, descobrimos rápido? | Métricas e alertas do comportamento alterado; canary ou liberação gradual quando couber, sem substituir a investigação prévia | Primeiro sinal de erro seria a reclamação do cliente |
| Recuperabilidade | Conseguimos conter e recuperar, e o que não volta? | Estratégia de recuperação adequada à mudança (rollback, flag, correção rápida), testada quando aplicável; plano de compensação para efeitos irreversíveis | Migração sem volta e sem plano |
| Risco residual (decisão, não evidência) | O que sobra, quem aceita e até quando? | Registro do risco que permanece (sem evidência suficiente ou mesmo depois de verificações favoráveis e controles), de quem aceitou e de quando será revisto | Ninguém sabe dizer o que sobrou, ou a aceitação aparece como se fosse teste |
Quem decide. Engenharia e QA respondem pela evidência: o que foi verificado, como e com que confiabilidade. A aceitação do risco residual é uma decisão compartilhada, com produto, negócio e, conforme o contexto, segurança, operação, jurídico ou compliance. QA não deveria ser o "aprovador do release" sozinho, nem ficar fora da decisão. O papel é tornar o risco visível e a evidência legível para quem decide.
8. Como eu abordaria esse problema hoje
Hoje, eu trabalharia pela independência dos testes: usar Docker para subir, por exemplo, um banco de dados que comece sempre zerado, derrubar o container ao final e garantir que o teste seguinte use um banco limpo.
A ideia central é que cada teste prepare os dados de que precisa e não dependa do que outro deixou. Um ambiente descartável com Docker é uma forma de chegar a isso, com um cuidado: remover o container não apaga, necessariamente, os dados gravados em volumes. A documentação do Docker diz que os dados de um volume persistem mesmo depois que o container que o usa é removido. Para o banco começar zerado de verdade, não basta dispensar o volume persistente ou removê-lo junto: a imagem usada, os scripts de inicialização e qualquer outro armazenamento compartilhado também precisam partir de um estado conhecido. Vale conferir no começo de cada execução que o banco está, de fato, no estado esperado. Bibliotecas como o Testcontainers automatizam esse ciclo, criando instâncias descartáveis de bancos e outros serviços durante os testes e removendo-as depois.
Na prática, há variações, escolhidas por custo e velocidade:
- Banco novo por execução da suíte, com limpeza ou transação desfeita a cada teste: mais rápido que um container por teste. Isola bem enquanto os testes rodam em sequência e o código testado não abre transações próprias que escapem do desfazer.
- Banco novo por teste: o isolamento mais forte de dados, com tempo de execução maior. Não isola, sozinho, outros estados compartilhados, como filas, caches ou serviços externos simulados.
- Dados únicos por teste (identificadores gerados), quando o banco é compartilhado: ajuda, mas não isola estado global, restrições de unicidade ou recursos disputados por testes em paralelo.
O objetivo comum é poder rodar qualquer teste sozinho, em qualquer ordem e, quando possível, em paralelo, com o mesmo resultado. Nenhuma das opções garante isso por si só: cada uma precisa ser verificada, por exemplo rodando a suíte em ordem aleatória. Isso responde ao critério de confiabilidade do modelo acima. Não responde aos outros cinco: um teste independente ainda pode produzir um falso negativo se a asserção dele for fraca.
9. Limitações
Este texto trata de software entregue continuamente, com suíte automatizada e decisão de release frequente. Não cobre sistemas regulados que exigem validação formal (saúde, aviação), nem aprofunda testes de desempenho e de segurança, que pedem evidências próprias. Os números citados são de fontes e épocas específicas e estão datados no texto.
10. Conclusão: qualidade é reduzir risco com evidências
Uma suíte verde é uma boa notícia e uma informação incompleta. Ela diz que as verificações executadas nesta rodada continuam com a resposta esperada. A decisão de liberar exige saber se essas eram as perguntas certas para esta mudança, se as respostas são confiáveis, o que não foi perguntado e o que acontece se a resposta estiver errada.
Qualidade, nesse sentido, não é a cor do pipeline. É reduzir risco com evidências: escolher os riscos que importam, produzir evidência confiável sobre eles, deixar visível o que sobrou e decidir, junto com quem responde pelo negócio, se vale liberar assim.
Referências
- DORA, Capabilities: Test automation (consultado em 18/11/2026)
- DORA, DORA's software delivery performance metrics (atualizado em 05/01/2026)
- Martin Fowler, TestCoverage (17/04/2012)
- John Micco, Flaky Tests at Google and How We Mitigate Them, Google Testing Blog (27/05/2016)
- Google, Canarying Releases, The Site Reliability Workbook
- Docker, Volumes, Docker Docs (consultado em 18/11/2026)
- Testcontainers (consultado em 18/11/2026)